🎓 论文说明:本文为作者在海南大学生命健康学院生物科学专业完成的本科毕业论文(设计)。指导教师:李宏。
摘 要
蛋白质-蛋白质相互作用(Protein-Protein Interaction, PPI)的预测对于揭示细胞调控网络、阐明疾病发病机理以及指导靶向药物设计具有重要战略意义。近期 Wu 等人提出了一种基于图神经网络(GNN)的 GHCT 模型(Graph residual connection attention Holistic processing multiple Channels graph Transformer),在预测 lncRNA-蛋白质相互作用(LPI)的二分图任务中展现出卓越的表征性能。
然而,当该架构面对高度连通、局部密集且充斥实验假阳性噪声的同构图(Homogeneous Graph)PPI 网络时,传统图深度学习常见的过平滑(Over-smoothing)、局部噪声敏感以及深层网络特征衰减等问题同样构成严峻挑战。
为验证 GHCT 架构跨越不同生物拓扑结构的通用计算能力,本研究重构了面向同构图的蛋白质节点特征编码方式,系统性优化了多通道注意力机制与训练超参数,将原本用于异构二分图的 GHCT 模型成功迁移至 PPI 预测任务中:
- 基准性能卓越:在来自 BioGRID 数据库的酿酒酵母(S. cerevisiae)与人类(H. sapiens)基准数据集上,测试集 AUC-ROC 分别达到 0.9534 与 0.9473,AUPR 分别达到 0.9626 与 0.9573;
- 极强抗噪鲁棒性:在人为引入 5% 与 10% 随机假阳性噪声的扰动实验中,模型 AUC 依然稳固在 0.9437 与 0.9368;
- 高度契合生理稀疏性:在模拟真实体内分子互作极度不平衡环境的 1:5 与 1:10 负样本测试中,AUC 不降反升并稳定在 0.9642 以上,证实模型能有效利用大量负样本边界约束特征空间。
实验证实,GHCT 并非仅针对特定任务的过拟合结构,而是一套具备强泛化能力与深层稳定性的通用分子拓扑表征计算范式。
关键词:蛋白质-蛋白质相互作用预测;图神经网络;全息注意力;图残差连接;多通道;生物信息学
Abstract
Prediction of Protein-Protein Interaction (PPI) is an essential cornerstone for deciphering cellular regulatory mechanisms, unraveling pathogenic pathways, and steering rational drug discovery. Recently, the novel Graph Neural Network-based GHCT model (Graph residual connection attention Holistic processing multiple Channels graph Transformer) has established superior benchmarks in predicting lncRNA-Protein Interaction (LPI) on bipartite graphs.
However, when applied to PPI homogeneous networks—characterized by dense inter-connectivity and experimental false-positive noise—graph neural architectures inevitably suffer from over-smoothing, vulnerability to topological perturbation, and deep feature vanishing.
To bridge this gap, this study systematically re-engineers node feature representations for homogeneous graphs and optimizes training paradigms and hyperparameter spaces to migrate GHCT to the PPI domain:
- Superior Predictive Accuracy: On benchmark datasets extracted from BioGRID (Saccharomyces cerevisiae and Homo sapiens), the framework delivers an AUC-ROC of 0.9534 and 0.9473, alongside AUPRs of 0.9626 and 0.9573;
- Exceptional Noise Robustness: Under 5% and 10% injected random structural noise, the AUC remains solidly resilient at 0.9437 and 0.9368;
- Natural Adaptation to Class Imbalance: In physiologically realistic sparse regimes with positive-to-negative ratios of 1:5 and 1:10, the AUC reaches 0.9643 and 0.9642, confirming its capacity to discriminate subtle biological boundaries.
These findings corroborate that GHCT serves as a versatile, robust graph topological framework capable of modeling complex biological molecular systems.
Keywords: Protein-Protein Interaction Prediction; Graph Neural Networks; Holistic Attention; Graph Residuals; Multi-Channel; Bioinformatics
1. 绪论与研究背景
1.1 蛋白质相互作用研究的演进
蛋白质作为生命活动的主要承担者,极少孤立发挥功能,而是通过瞬时或稳定的相互作用形成动态复合体网络,参与诸如信号转导、DNA 复制与修复、免疫应答等关键生物学过程。
传统湿实验(如酵母双杂交 Y2H、串联亲和纯化质谱 TAP-MS)成本高昂、耗时漫长,且易受实验条件限制产生大量假阳性与假阴性。早期机器学习方法(支持向量机 SVM、随机森林 RF)依赖人工设计的手工物化特征(如二肽频次、亲疏水性自相关),泛化能力受限。随后的卷积神经网络(CNN)和双向 LSTM 实现了序列自提取,但本质上仍停留在一维线性空间,完全丢失了蛋白质折叠后的三维空间构象与全生命网络拓扑信息。
1.2 图神经网络(GNN)的机遇与深层瓶颈
图神经网络将每一个蛋白质抽象为网络中的节点 $v \in \mathcal{V}$,物理结合或功能协作关系抽象为边 $e \in \mathcal{E}$,借助邻域聚合(Message Passing)机制整合拓扑上下文。
但在处理复杂 PPI 网络时,经典 GNN 暴露出三大关键瓶颈:
- 过平滑问题(Over-smoothing):当网络层数加深(如超过 3-4 层),节点特征反复与邻居求均值,最终所有节点的向量趋于同质化,完全丧失分类辨识力;
- 长距离依赖缺失:局部消息传递机制难以跨越稀疏图的长游走路径捕获高阶功能模块信息;
- 真实实验噪声敏感:高通量生物网络中普遍存在 5%~20% 的假阳性噪声边,局部卷积极易被错误拓扑带偏。
1.3 GHCT 模型架构与其核心技术突破
为解决上述挑战,Wu 等人于 2025 年在计算机与信息科学权威期刊 Knowledge-Based Systems 上提出了 GHCT 架构。
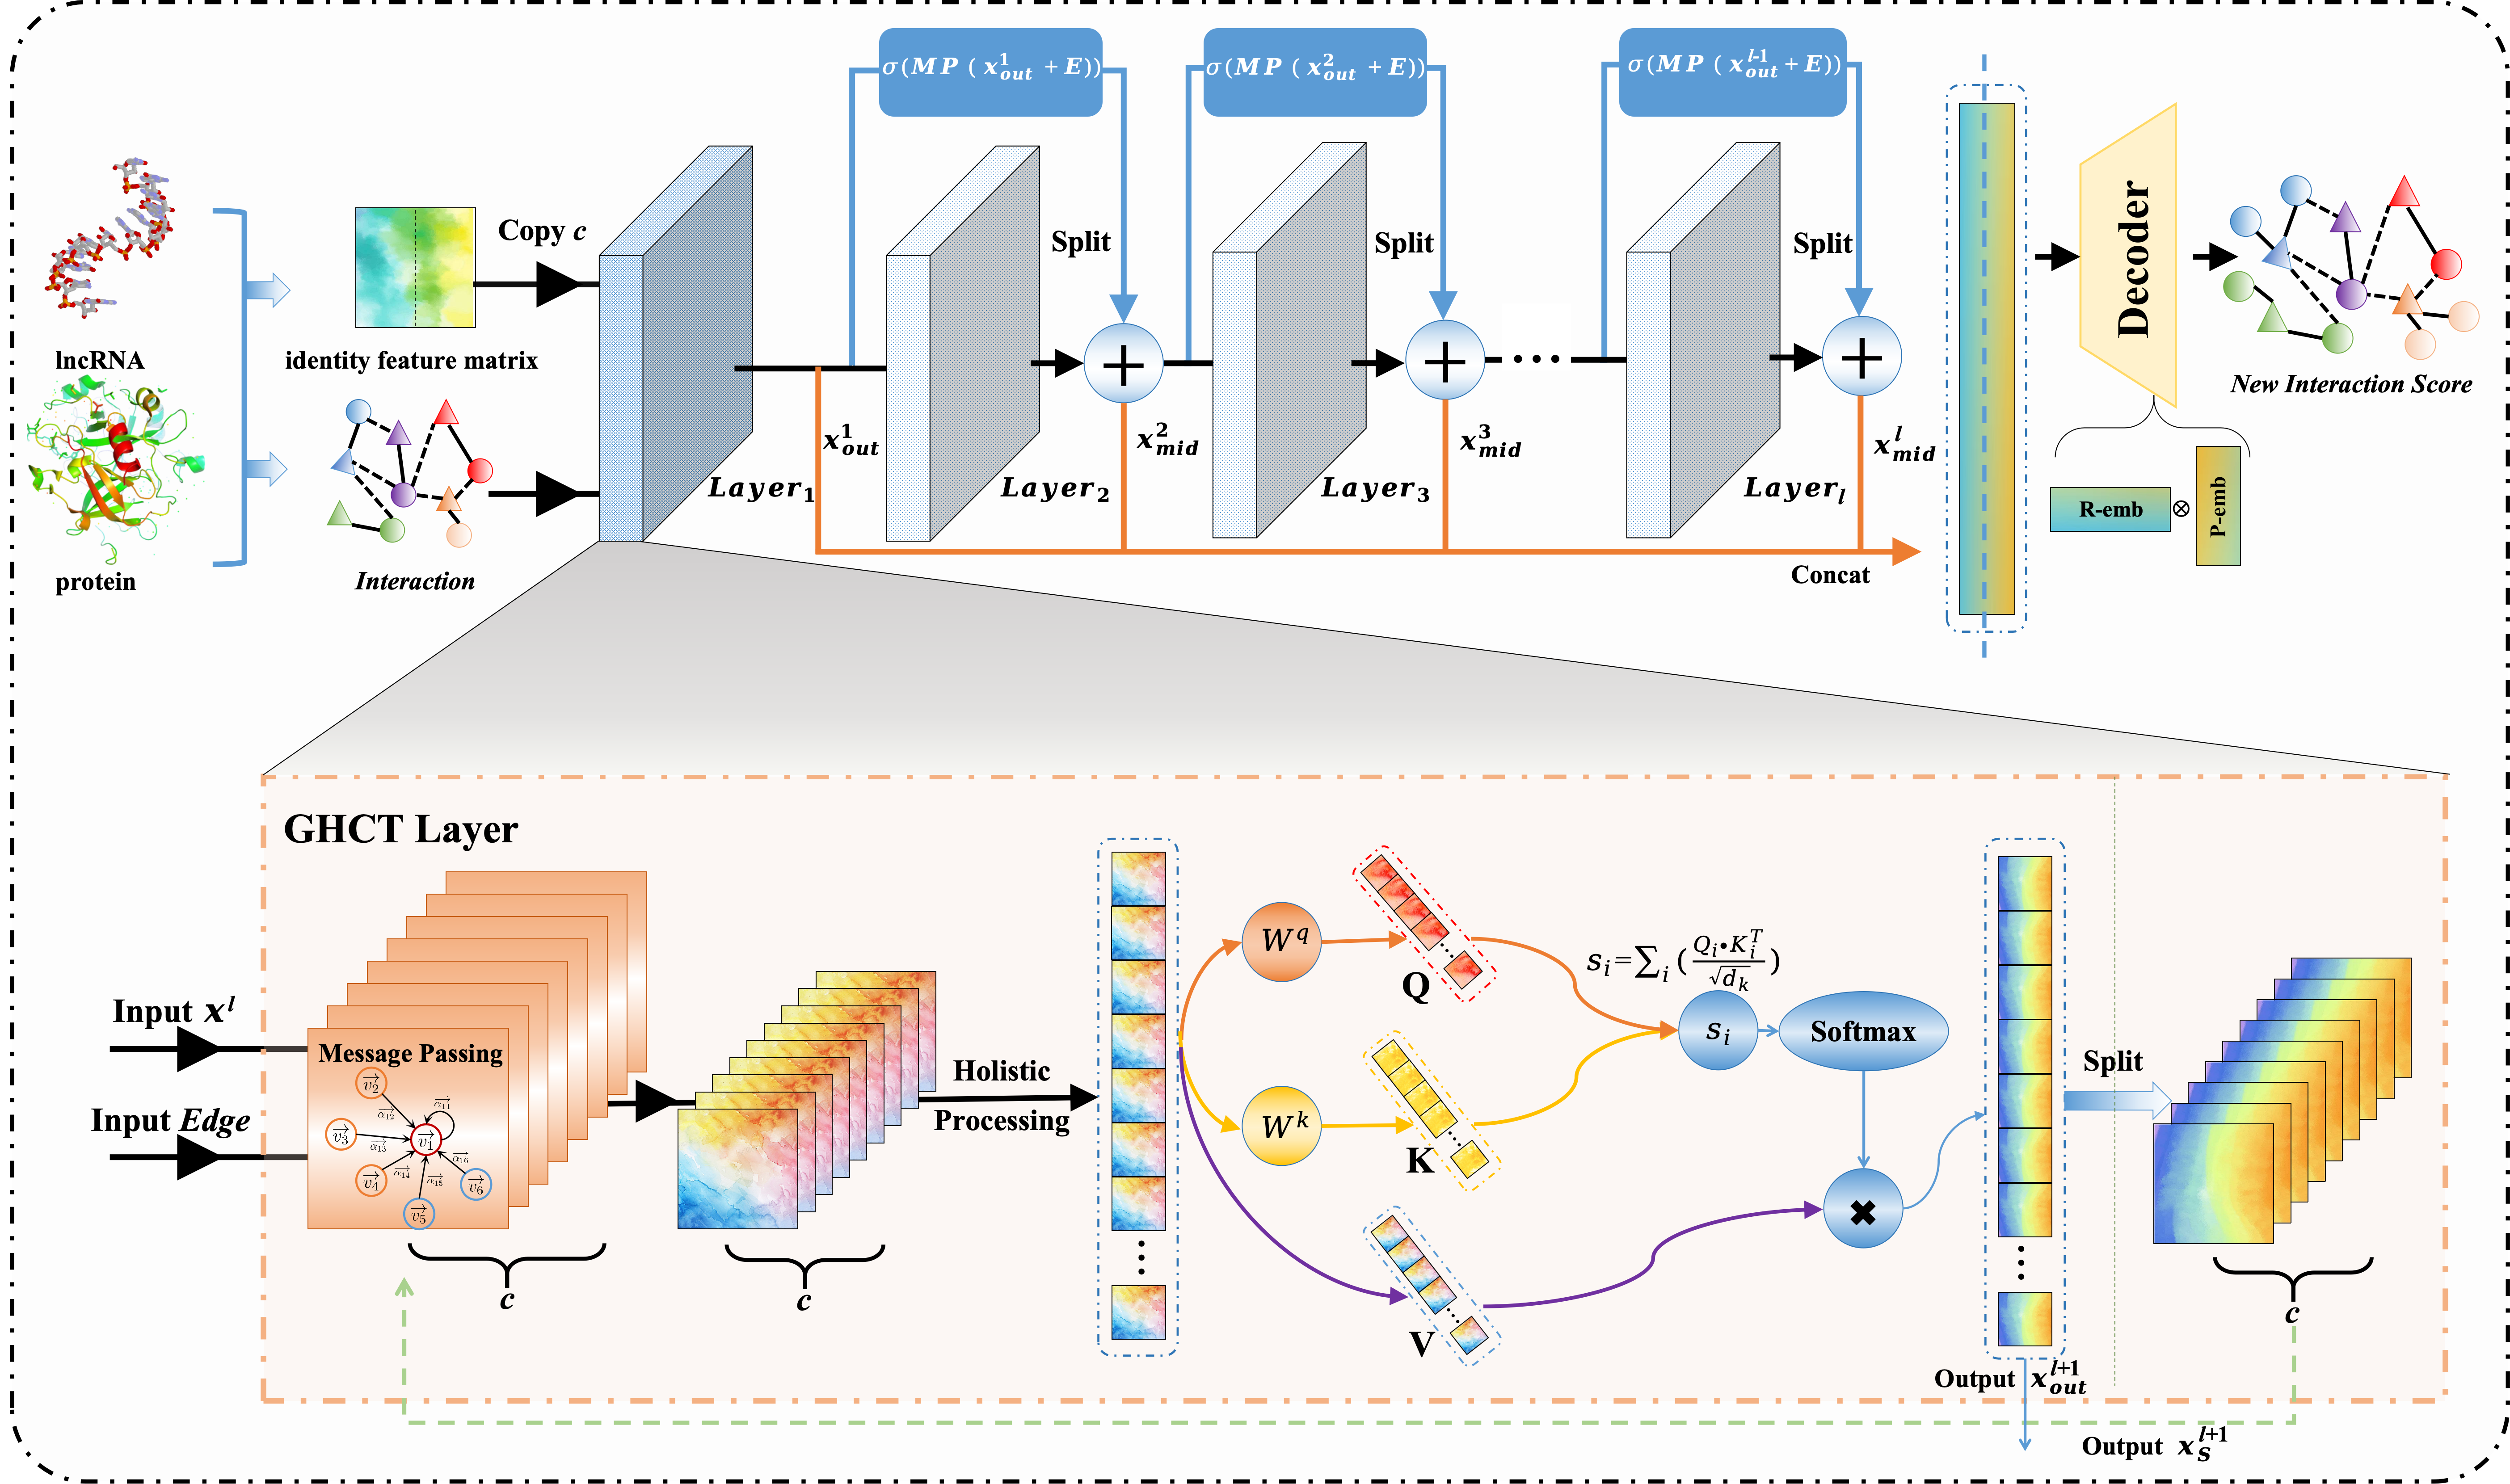
GHCT 的技术创新主要由三大支柱构成:
- 全息注意力多通道图 Transformer(Holistic Attention Graph Transformer):抛弃局部受限卷积,引入跨通道全局自注意力机制,能够以全局宏观视角同时评估通道内与通道间的相互关系,有效捕获长距离拓扑依赖;
- 深度图残差网络(Deep Graph Residual Network):在层级间引入专用残差跳跃连接(Residual Shortcuts),允许原始浅层高保真特征跨层直通,从数学机制上杜绝了深层堆叠时的梯度消失与过平滑;
- 恒等特征矩阵与潜在空间自适应表征:以 One-hot 恒等矩阵作为初始输入,促使网络在隐空间中端到端自适应学习节点的高阶嵌入,显著降低对昂贵手工特征的依赖。
2. 模型迁移与同构图实验设计
2.1 数据集构建与负采样机制
本研究基于权威 BioGRID (v4.4) 数据库,严格筛选经物理实验多重验证的高置信度互作数据:
- 人类数据集(Homo sapiens):精选 15,000 条高置信互作对;
- 酿酒酵母数据集(Saccharomyces cerevisiae):精选 15,000 条高置信互作对;
- 剔除自环(Self-loops)与多重重叠边,按照 7 : 3 的比例划分为训练集(10,500 对)与独立测试集(4,500 对);
- 负样本策略:训练阶段采用动态负采样策略,测试集预先构建 1:1 独立评估基准,并进一步扩展至 1:5 与 1:10 极度稀疏测试集。
2.2 面向同构图的 GHCT 架构适配
原版 GHCT 是为处理 lncRNA 与蛋白质两类异质实体的二分图(Bipartite Graph)而设计的。在 PPI 任务中,所有节点均为蛋白质,网络退化为同构图(Homogeneous Graph)。
为此,本研究重构了底层编码实现:
- 剔除原代码中双分支独立的投影与切分通道;
- 构建基于 UniProt Swiss-Prot 唯一标识符的连续整数索引拓扑映射;
- 统一所有通道的并行图前向传播算子,完整保留全息注意力与深度图残差的数学特性。
2.3 超参数调优与敏感度分析
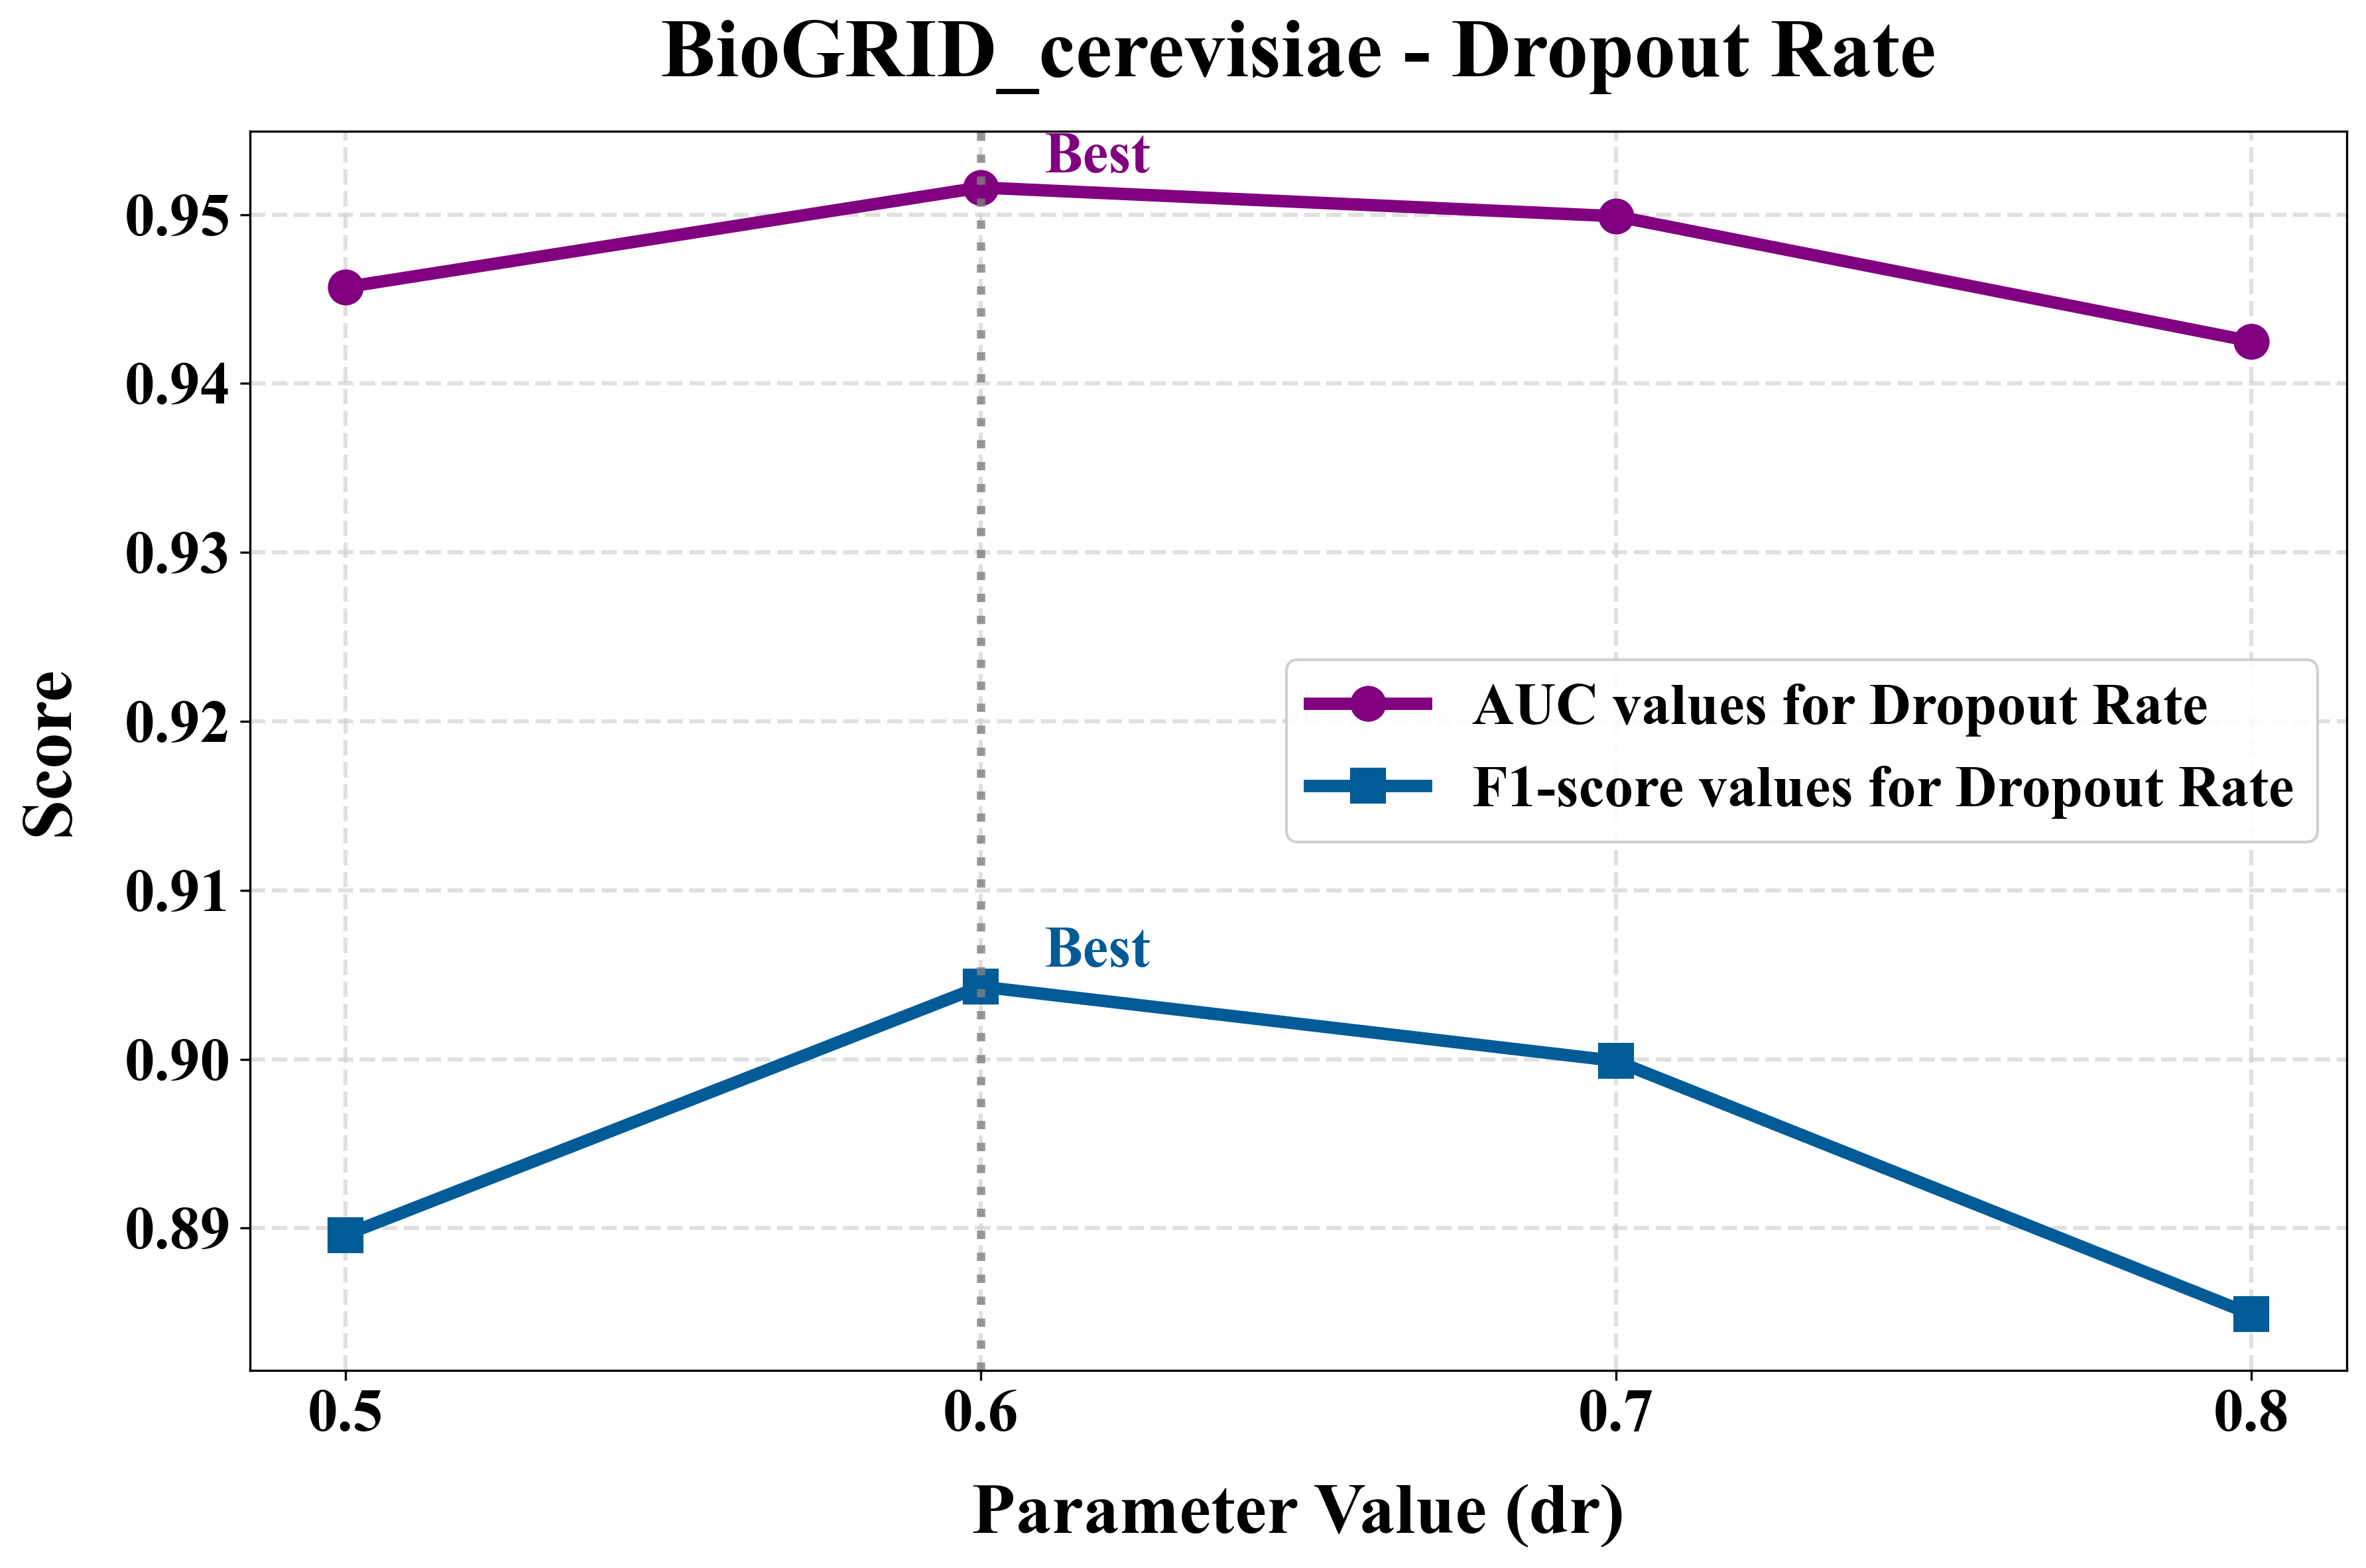
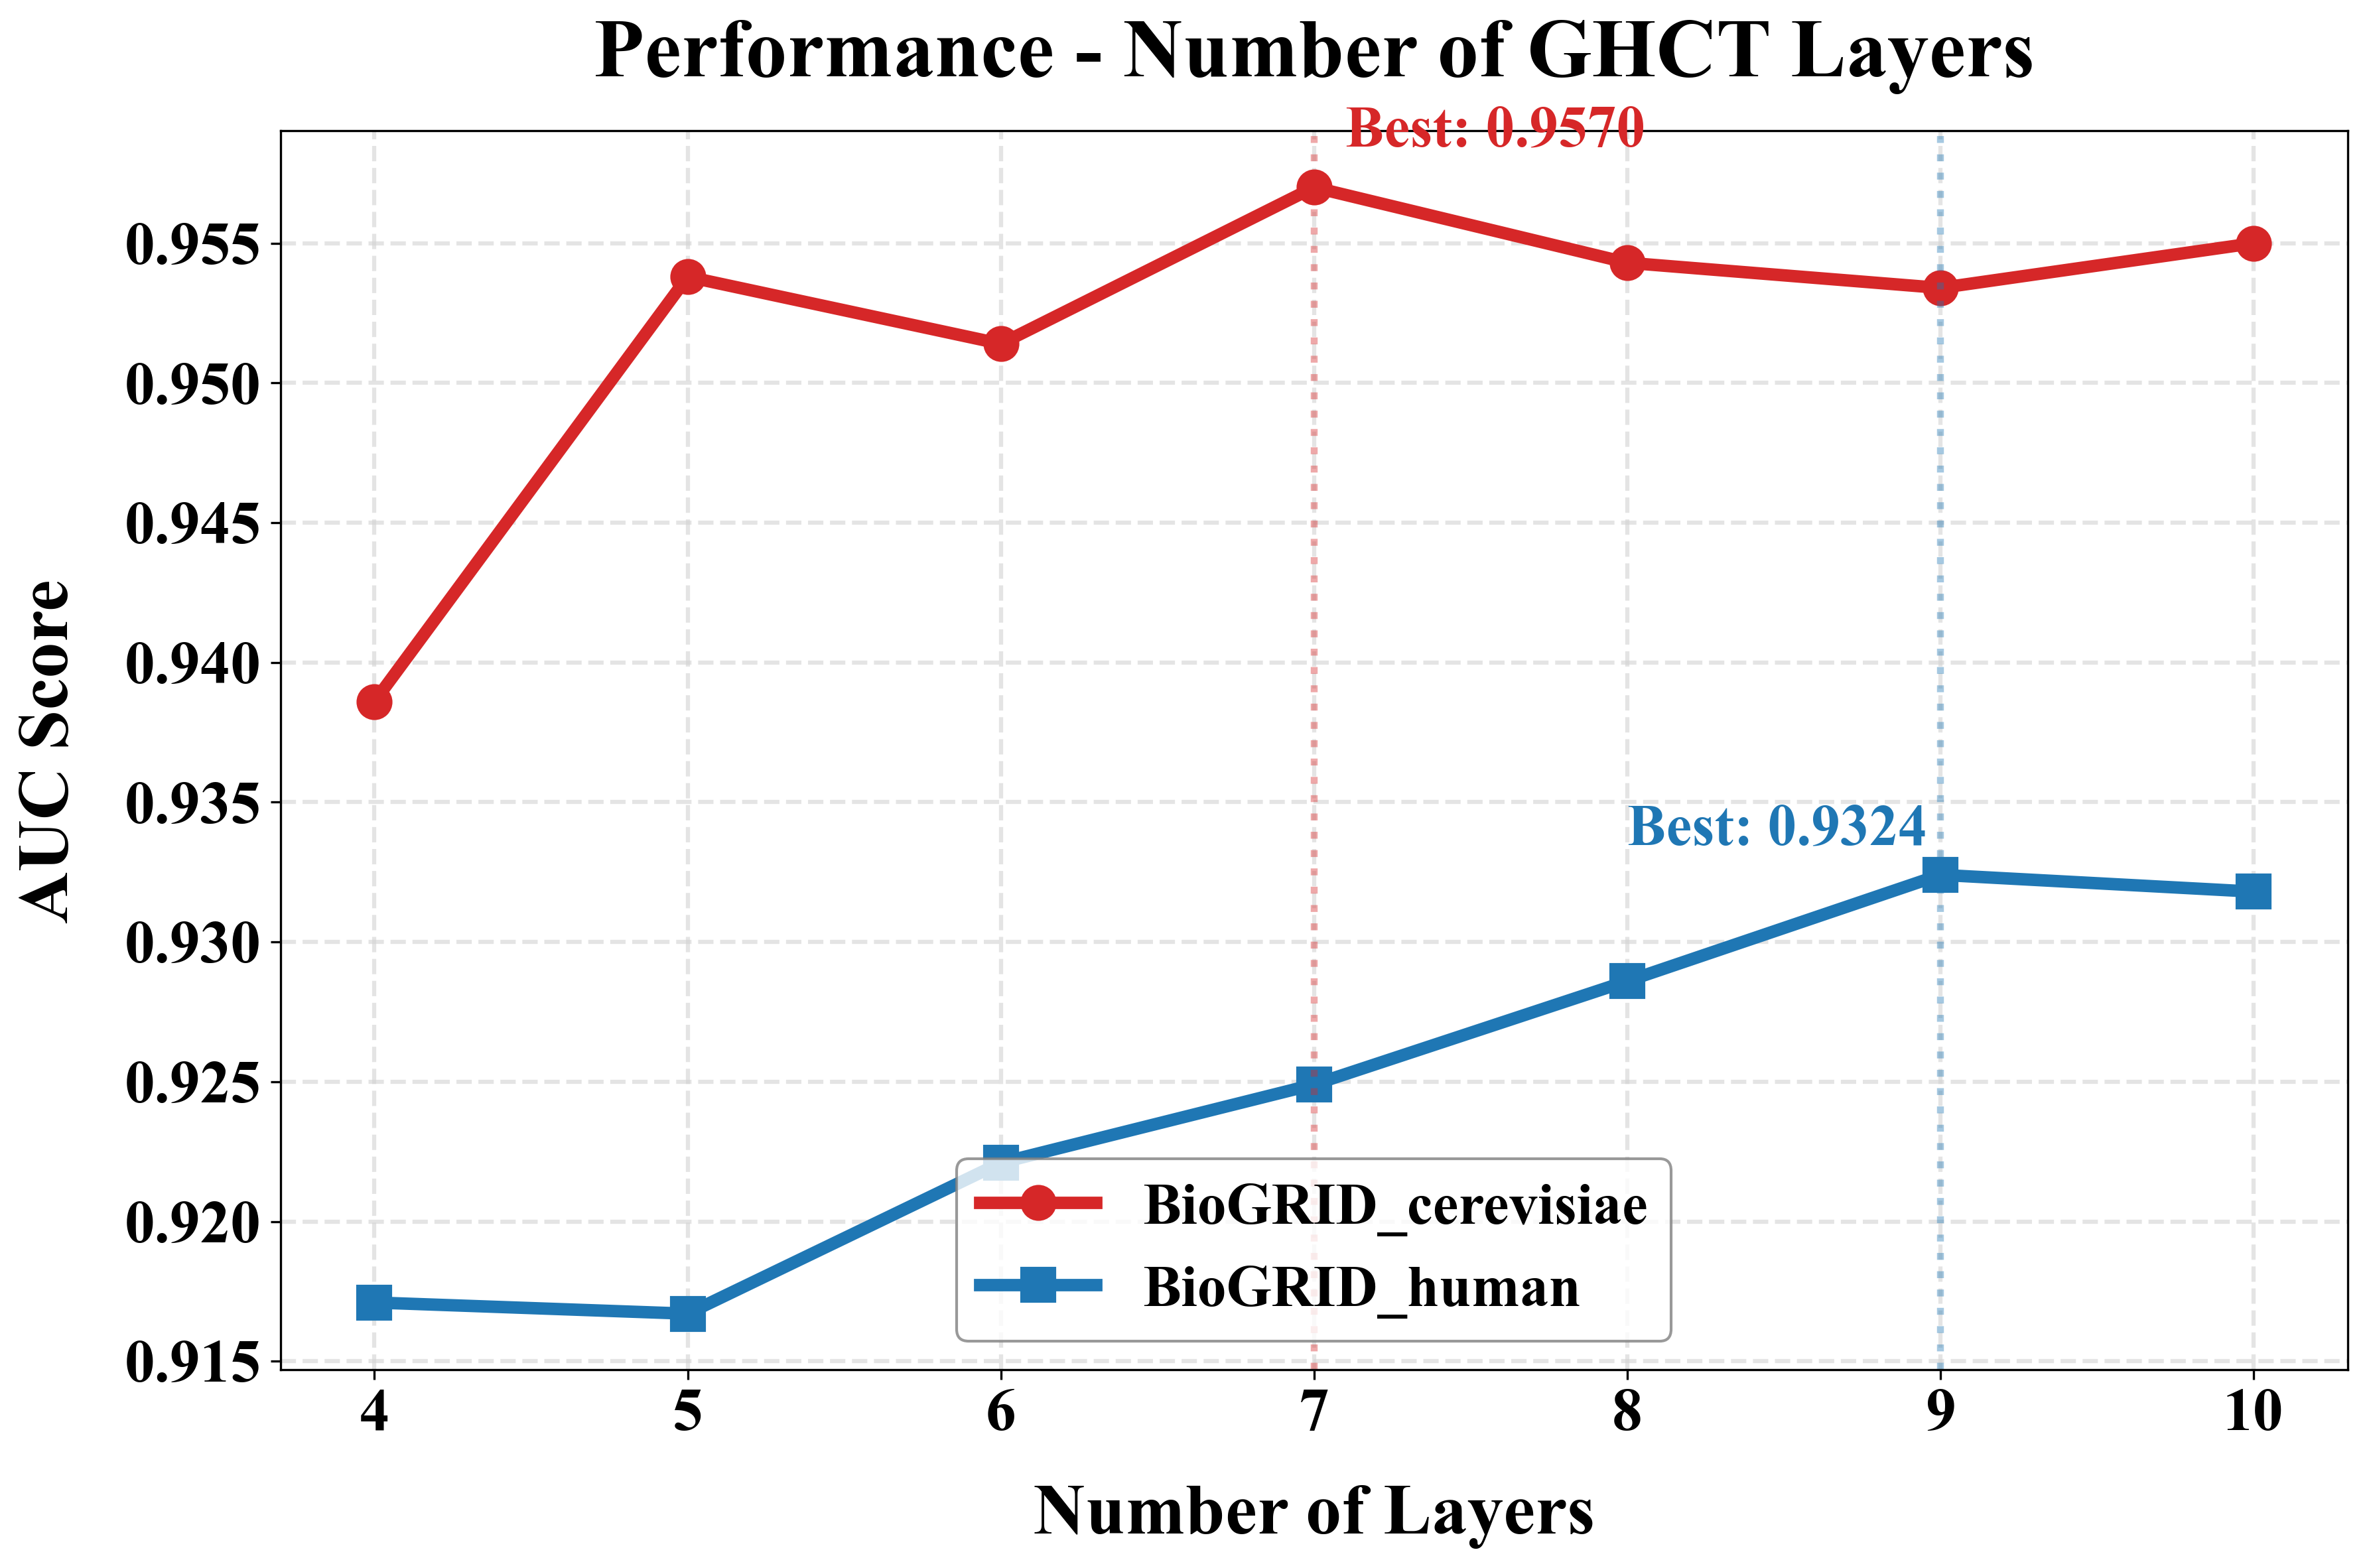
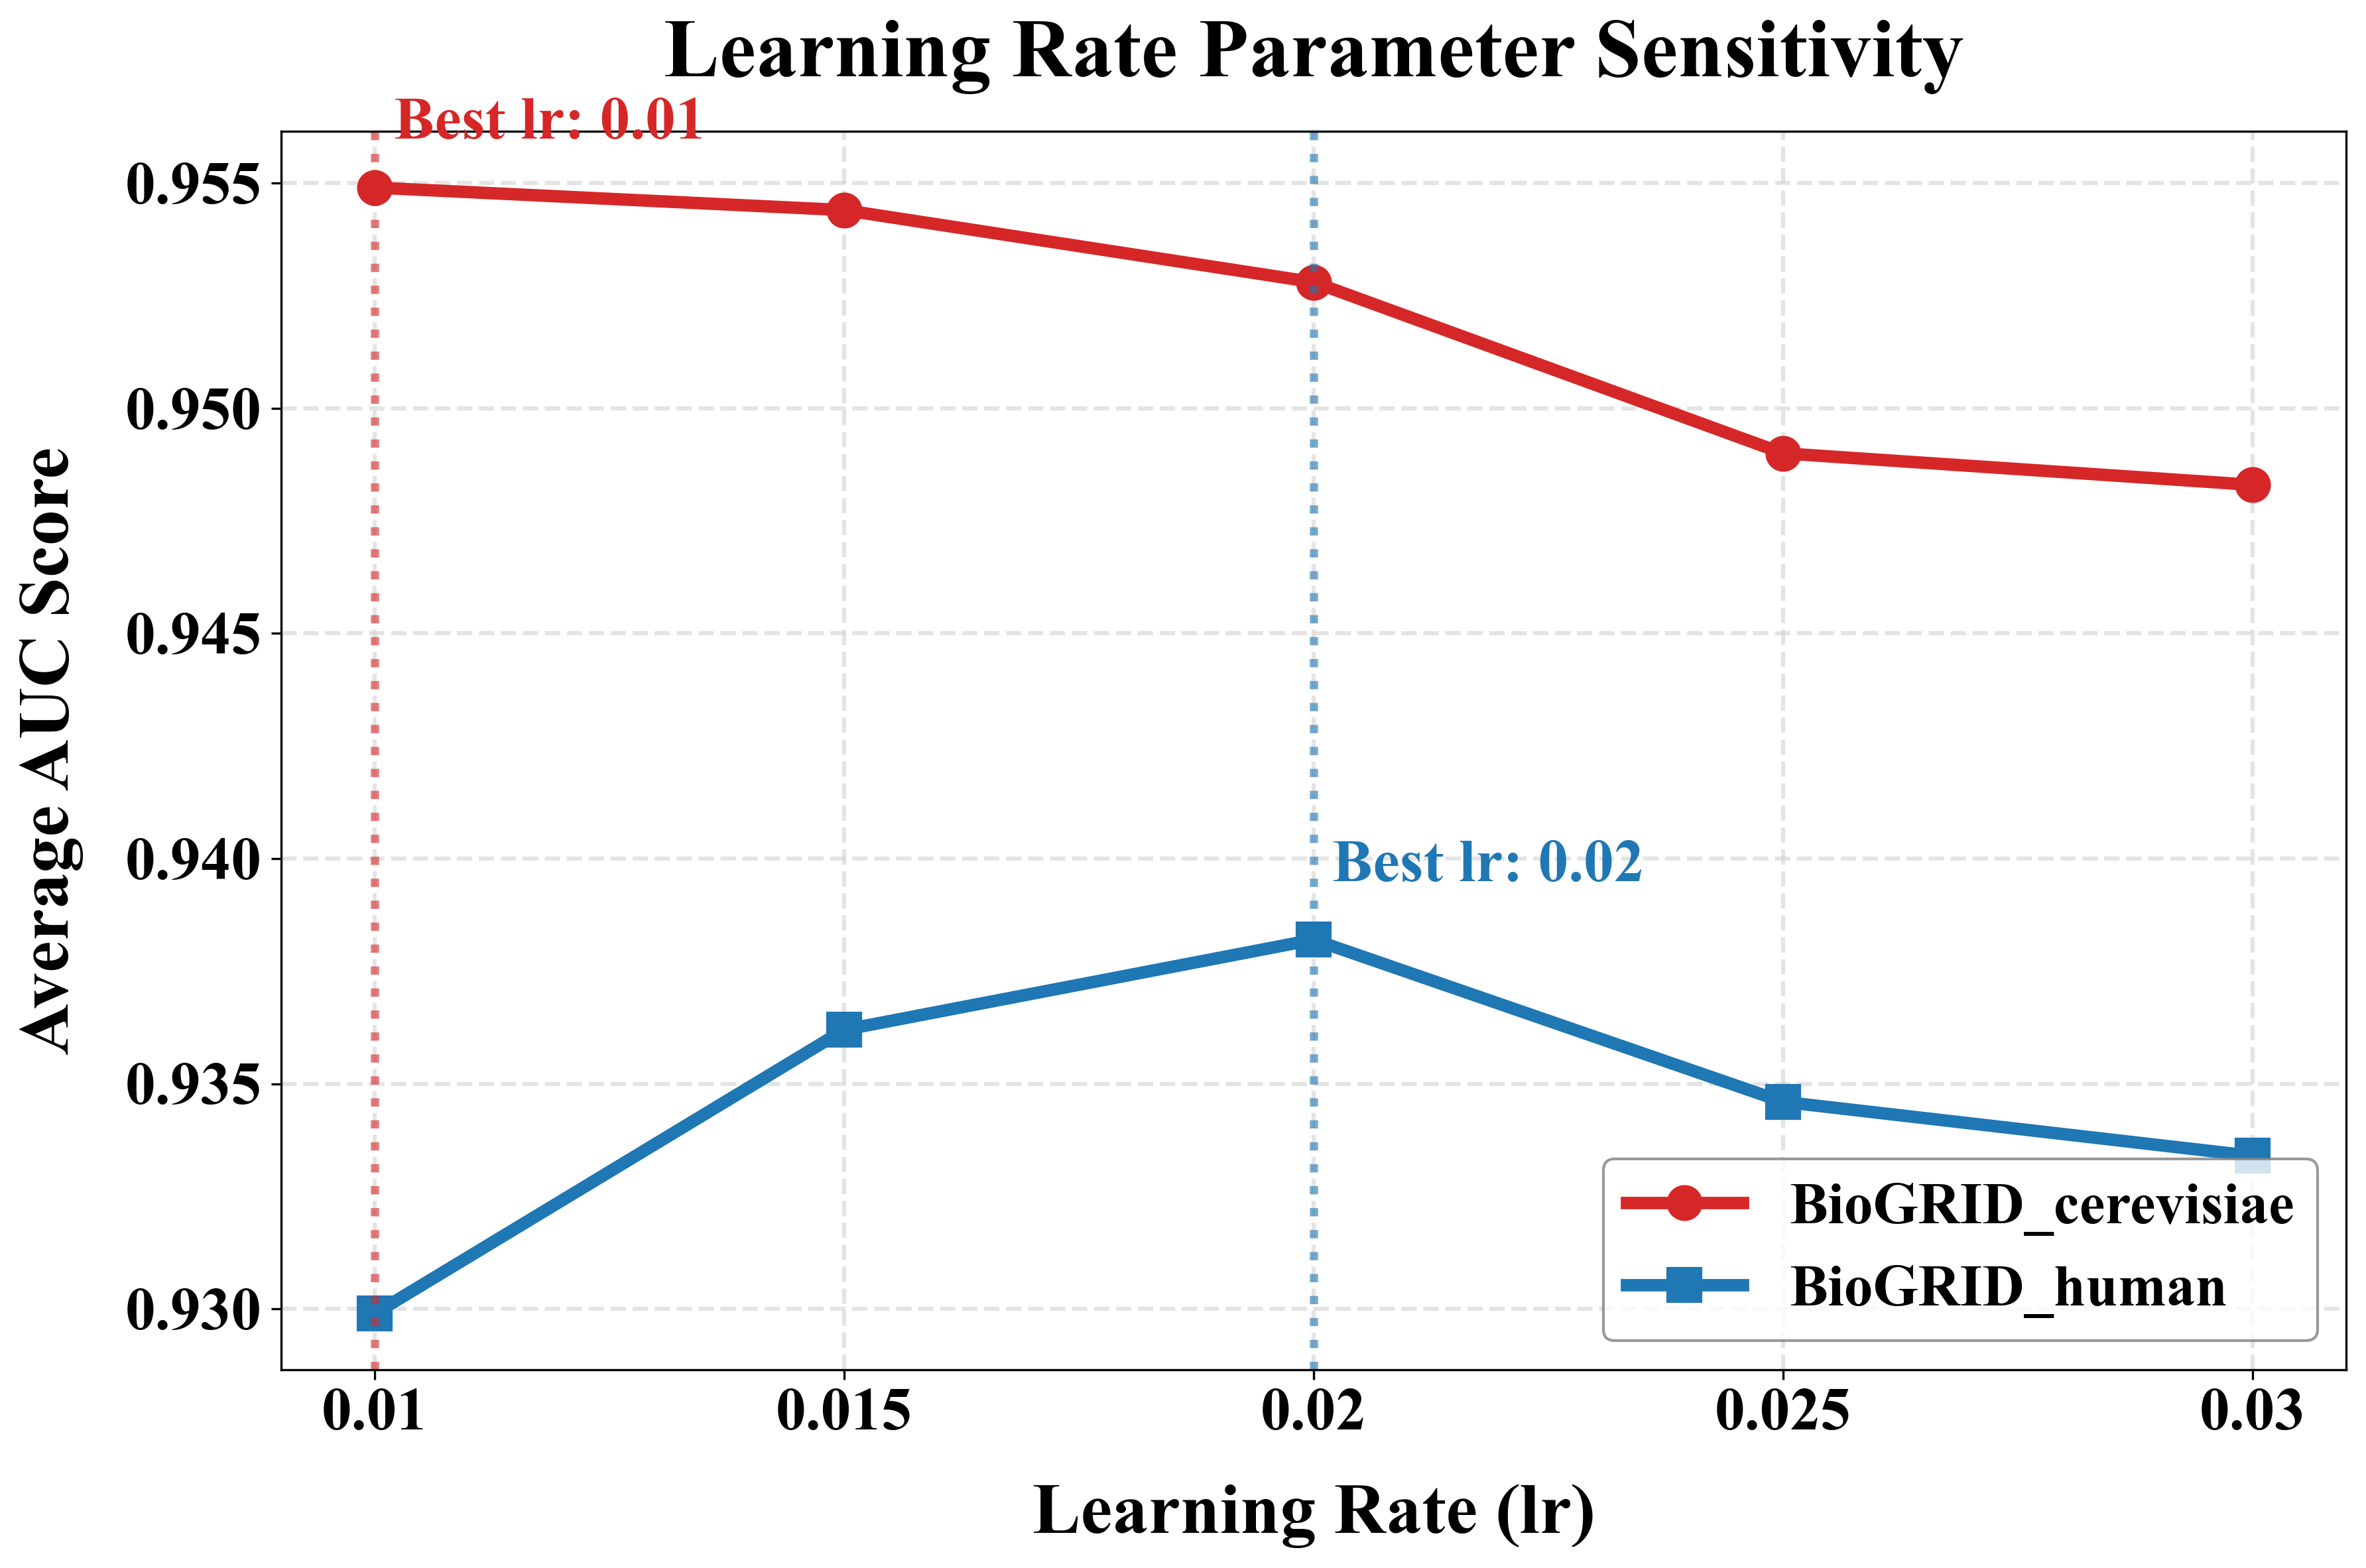
通过网格搜索对网络层数(Layers)、通道数(Channels)与学习率(Learning Rate)展开系统调优:
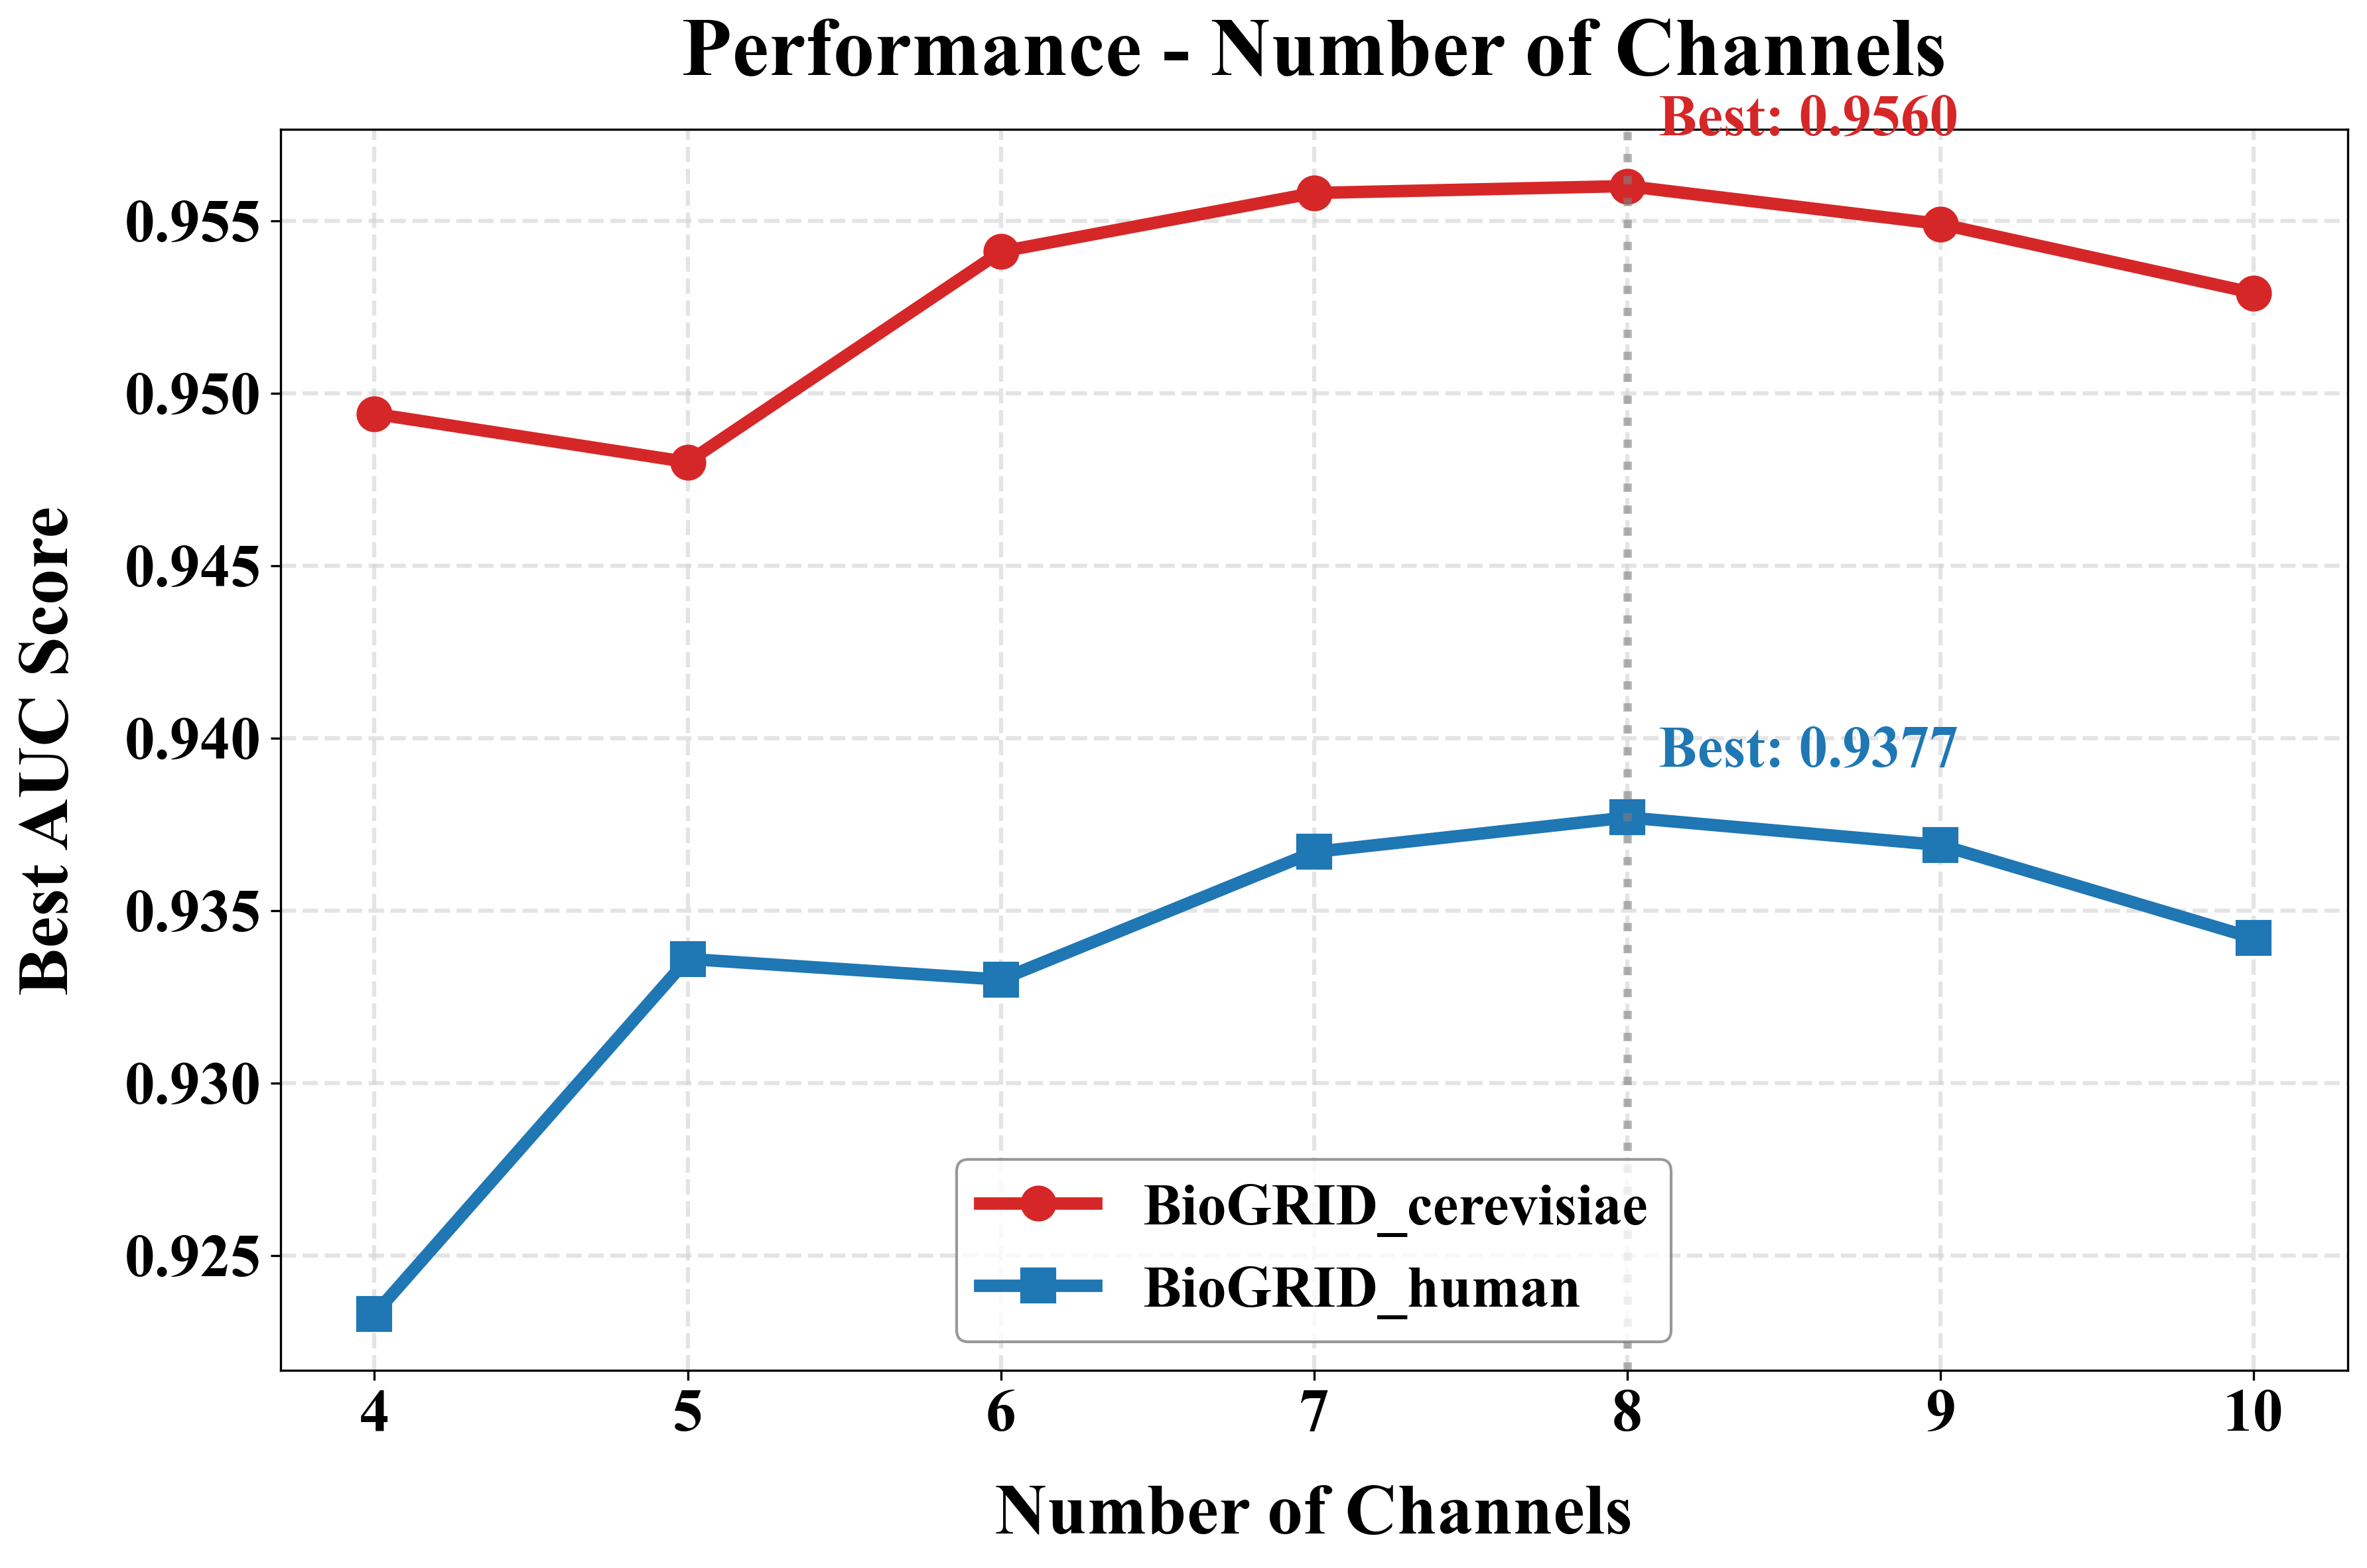
- 最终确定基准拓扑超参数:
Layers = 8,Channels = 8; - 优化器采用 Adam,学习率设定为人类数据集 $\eta = 0.02$,酿酒酵母数据集 $\eta = 0.01$;
- 实验表明,得益于图残差结构,网络在堆叠至 8 层甚至更高时并未发生过平滑崩溃,反而持续展现出特征聚合增益。
3. 实验结果与深度讨论
3.1 PPI 数据集上的综合性能指标
在平衡基准测试集(1:1)上,经过收敛训练的 GHCT 模型展现出极高的分类精度:
| 数据集 | AUC-ROC | AUPR | F1-Score | Accuracy | Recall | Specificity | Precision |
|---|---|---|---|---|---|---|---|
| Human (人类) | 0.9473 | 0.9573 | 0.8962 | 89.79% | 88.20% | 91.38% | 91.09% |
| Yeast (酿酒酵母) | 0.9534 | 0.9626 | 0.9031 | 90.36% | 90.93% | 90.78% | 90.70% |
在两大数据集上,阈值无关的综合指标 AUC 与 AUPR 均稳定超越 0.94~0.96,精确率与特异性平衡维持在 90% 以上,证明模型在同构图拓扑下具备极强的正负样本排序与判别能力。
3.2 消融实验:三大核心组件的贡献拆解
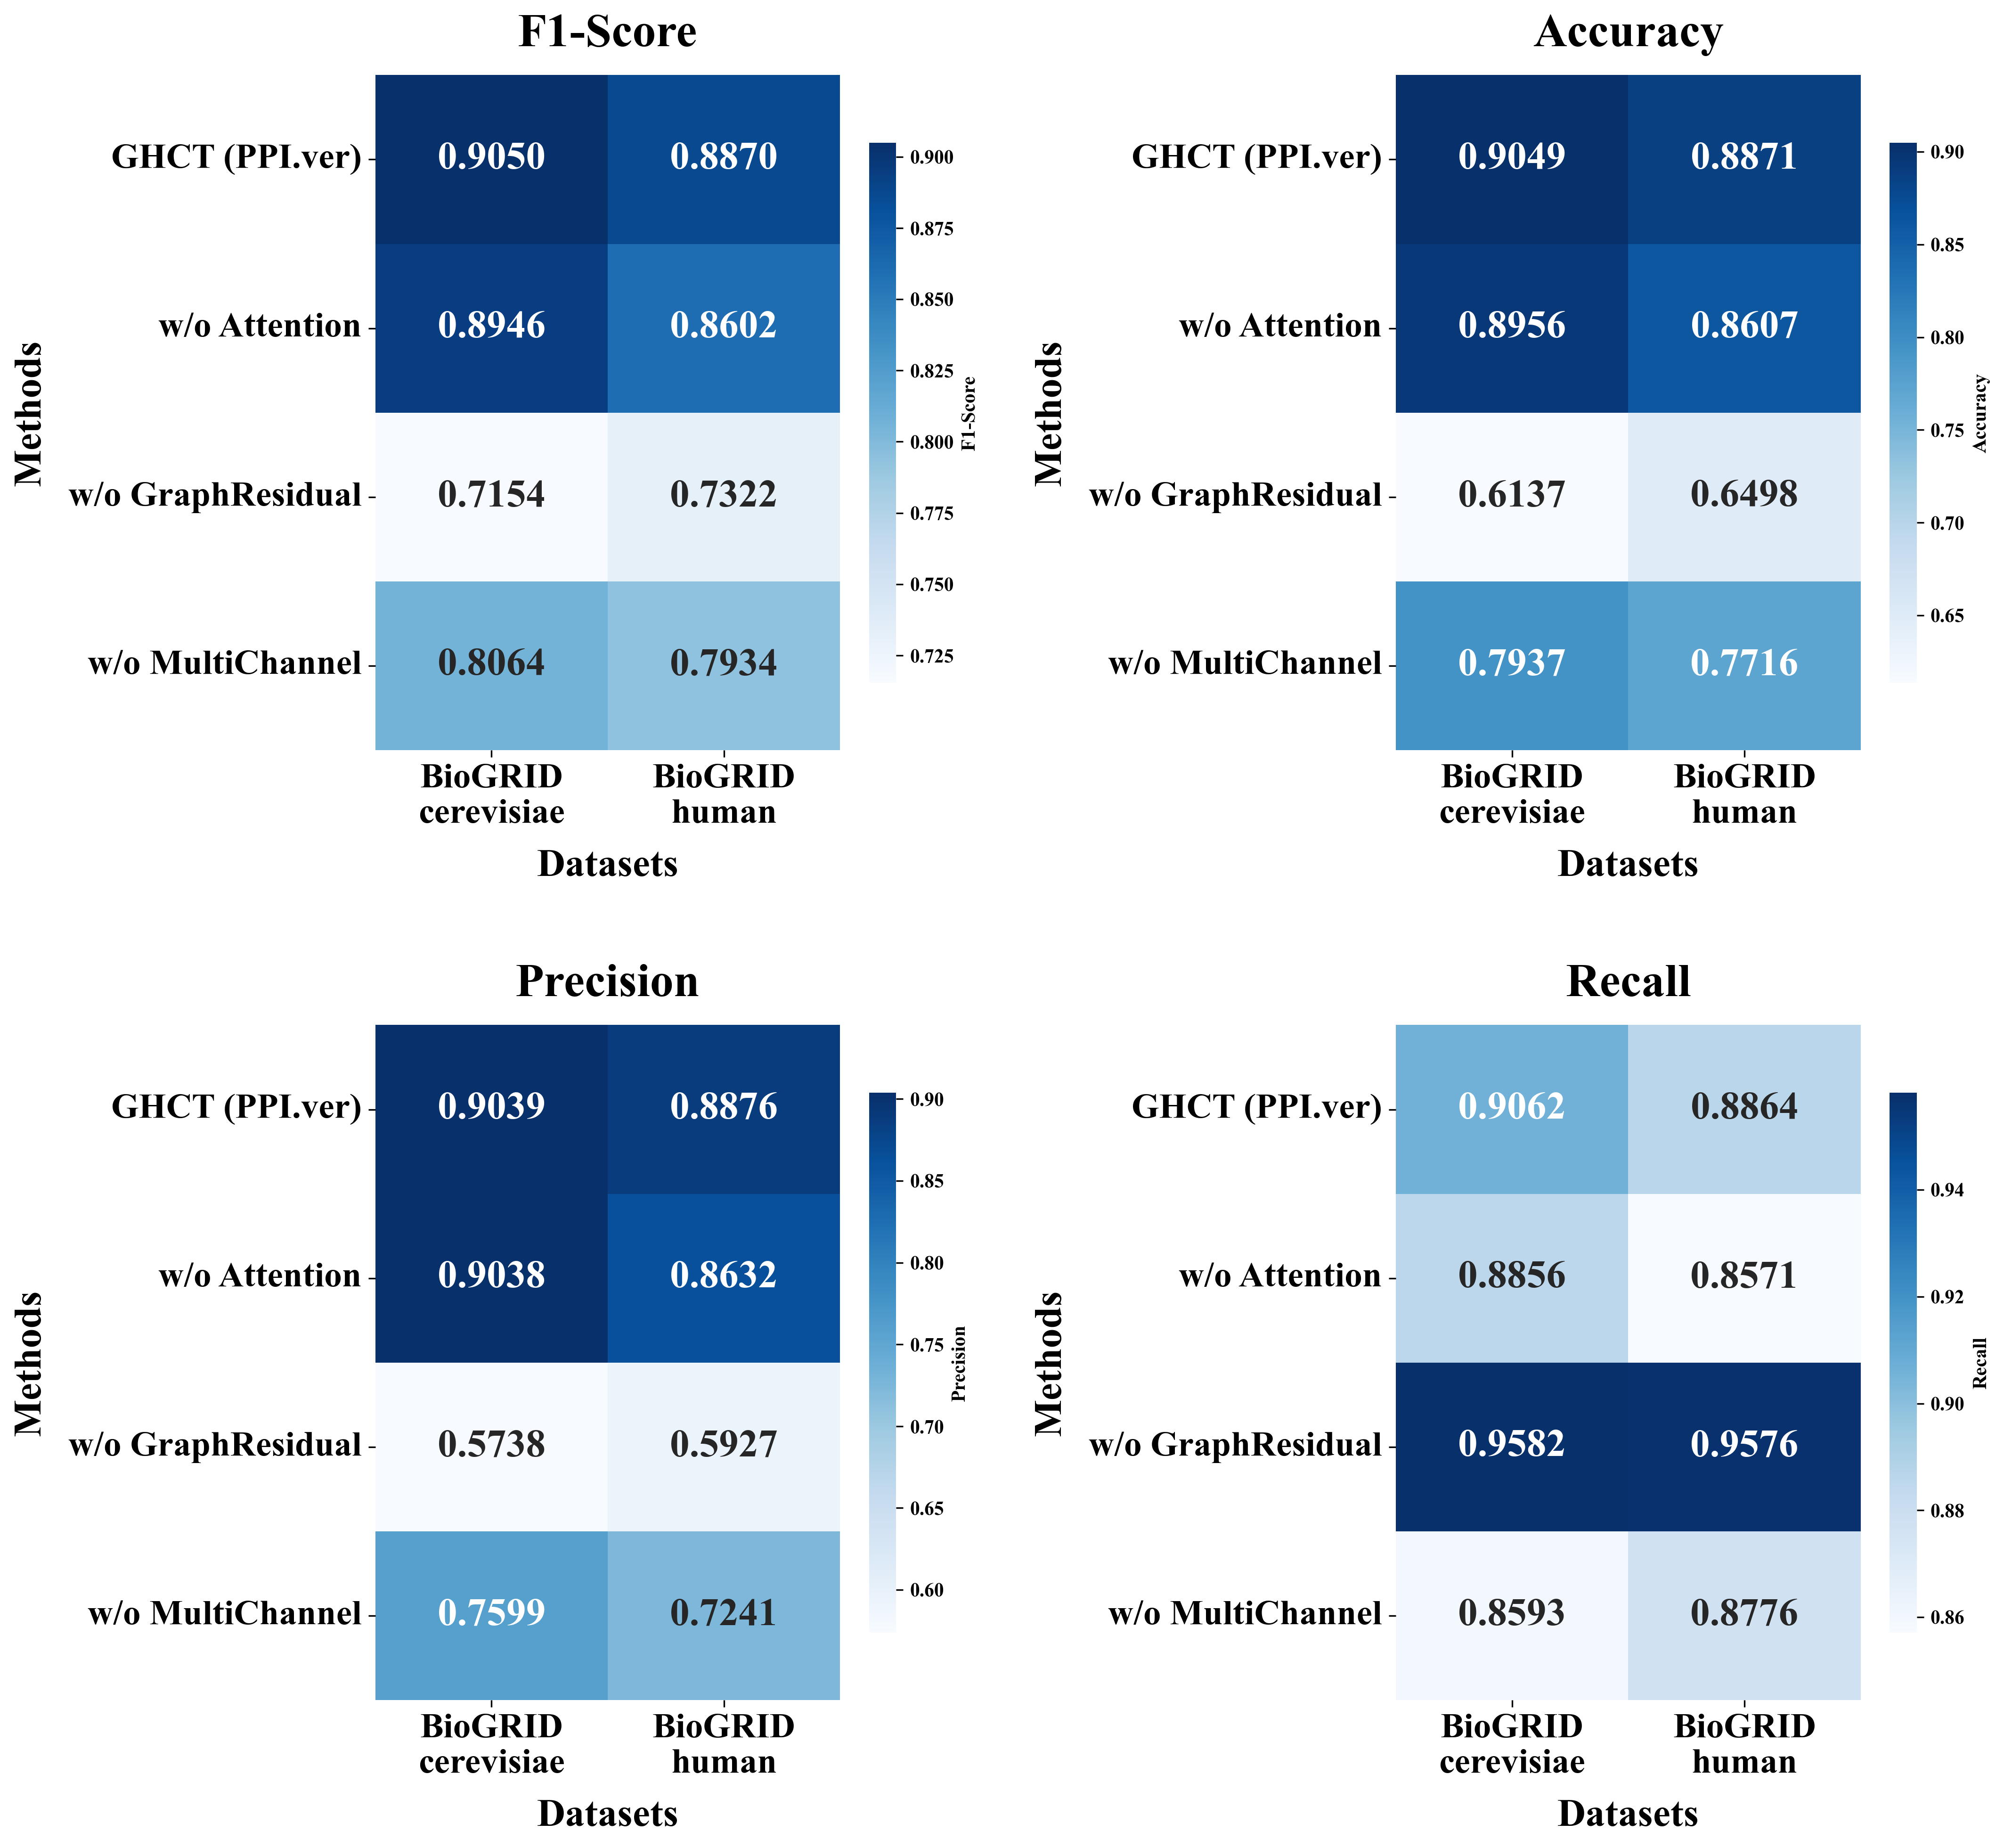
为了量化各设计模块的实际收益,研究在 Layers = 8 的深层配置下开展了严格的消融实验(Ablation Study):
w/o Attention:移除全局全息注意力机制;w/o GraphResidual:移除图残差跳跃连接;w/o MultiChannel:缩减为单通道表征。
实验深度结论:
- 图残差(Graph Residual)是深层稳定的命脉: 移除图残差后,模型性能发生崩塌——ACC 暴跌 32%,Precision 暴跌 36%,F1 骤降 21%,而 Recall 反向虚高 5.7%。这无可辩驳地证实:在 8 层的同构图中,没有残差保护的网络发生了灾难性的过平滑,特征极度同质化,模型失去判别边界并倾向于将所有样本判定为正样本!
- 多通道并行编码(Multi-Channel)提供高容量特征空间: 剔除多通道机制后,ACC 下降 12%,Precision 下降 16%,证明单通道无法承载多面复杂的蛋白质功能互作模式;
- 全息注意力(Holistic Attention)平衡宏观全局依赖: 移除注意力后,召回率下降 2.3%,F1 下降 1.1%,表明全局自注意力有效消除了局部视野盲区。
3.3 噪声鲁棒性实验:抵御实验假阳性干扰
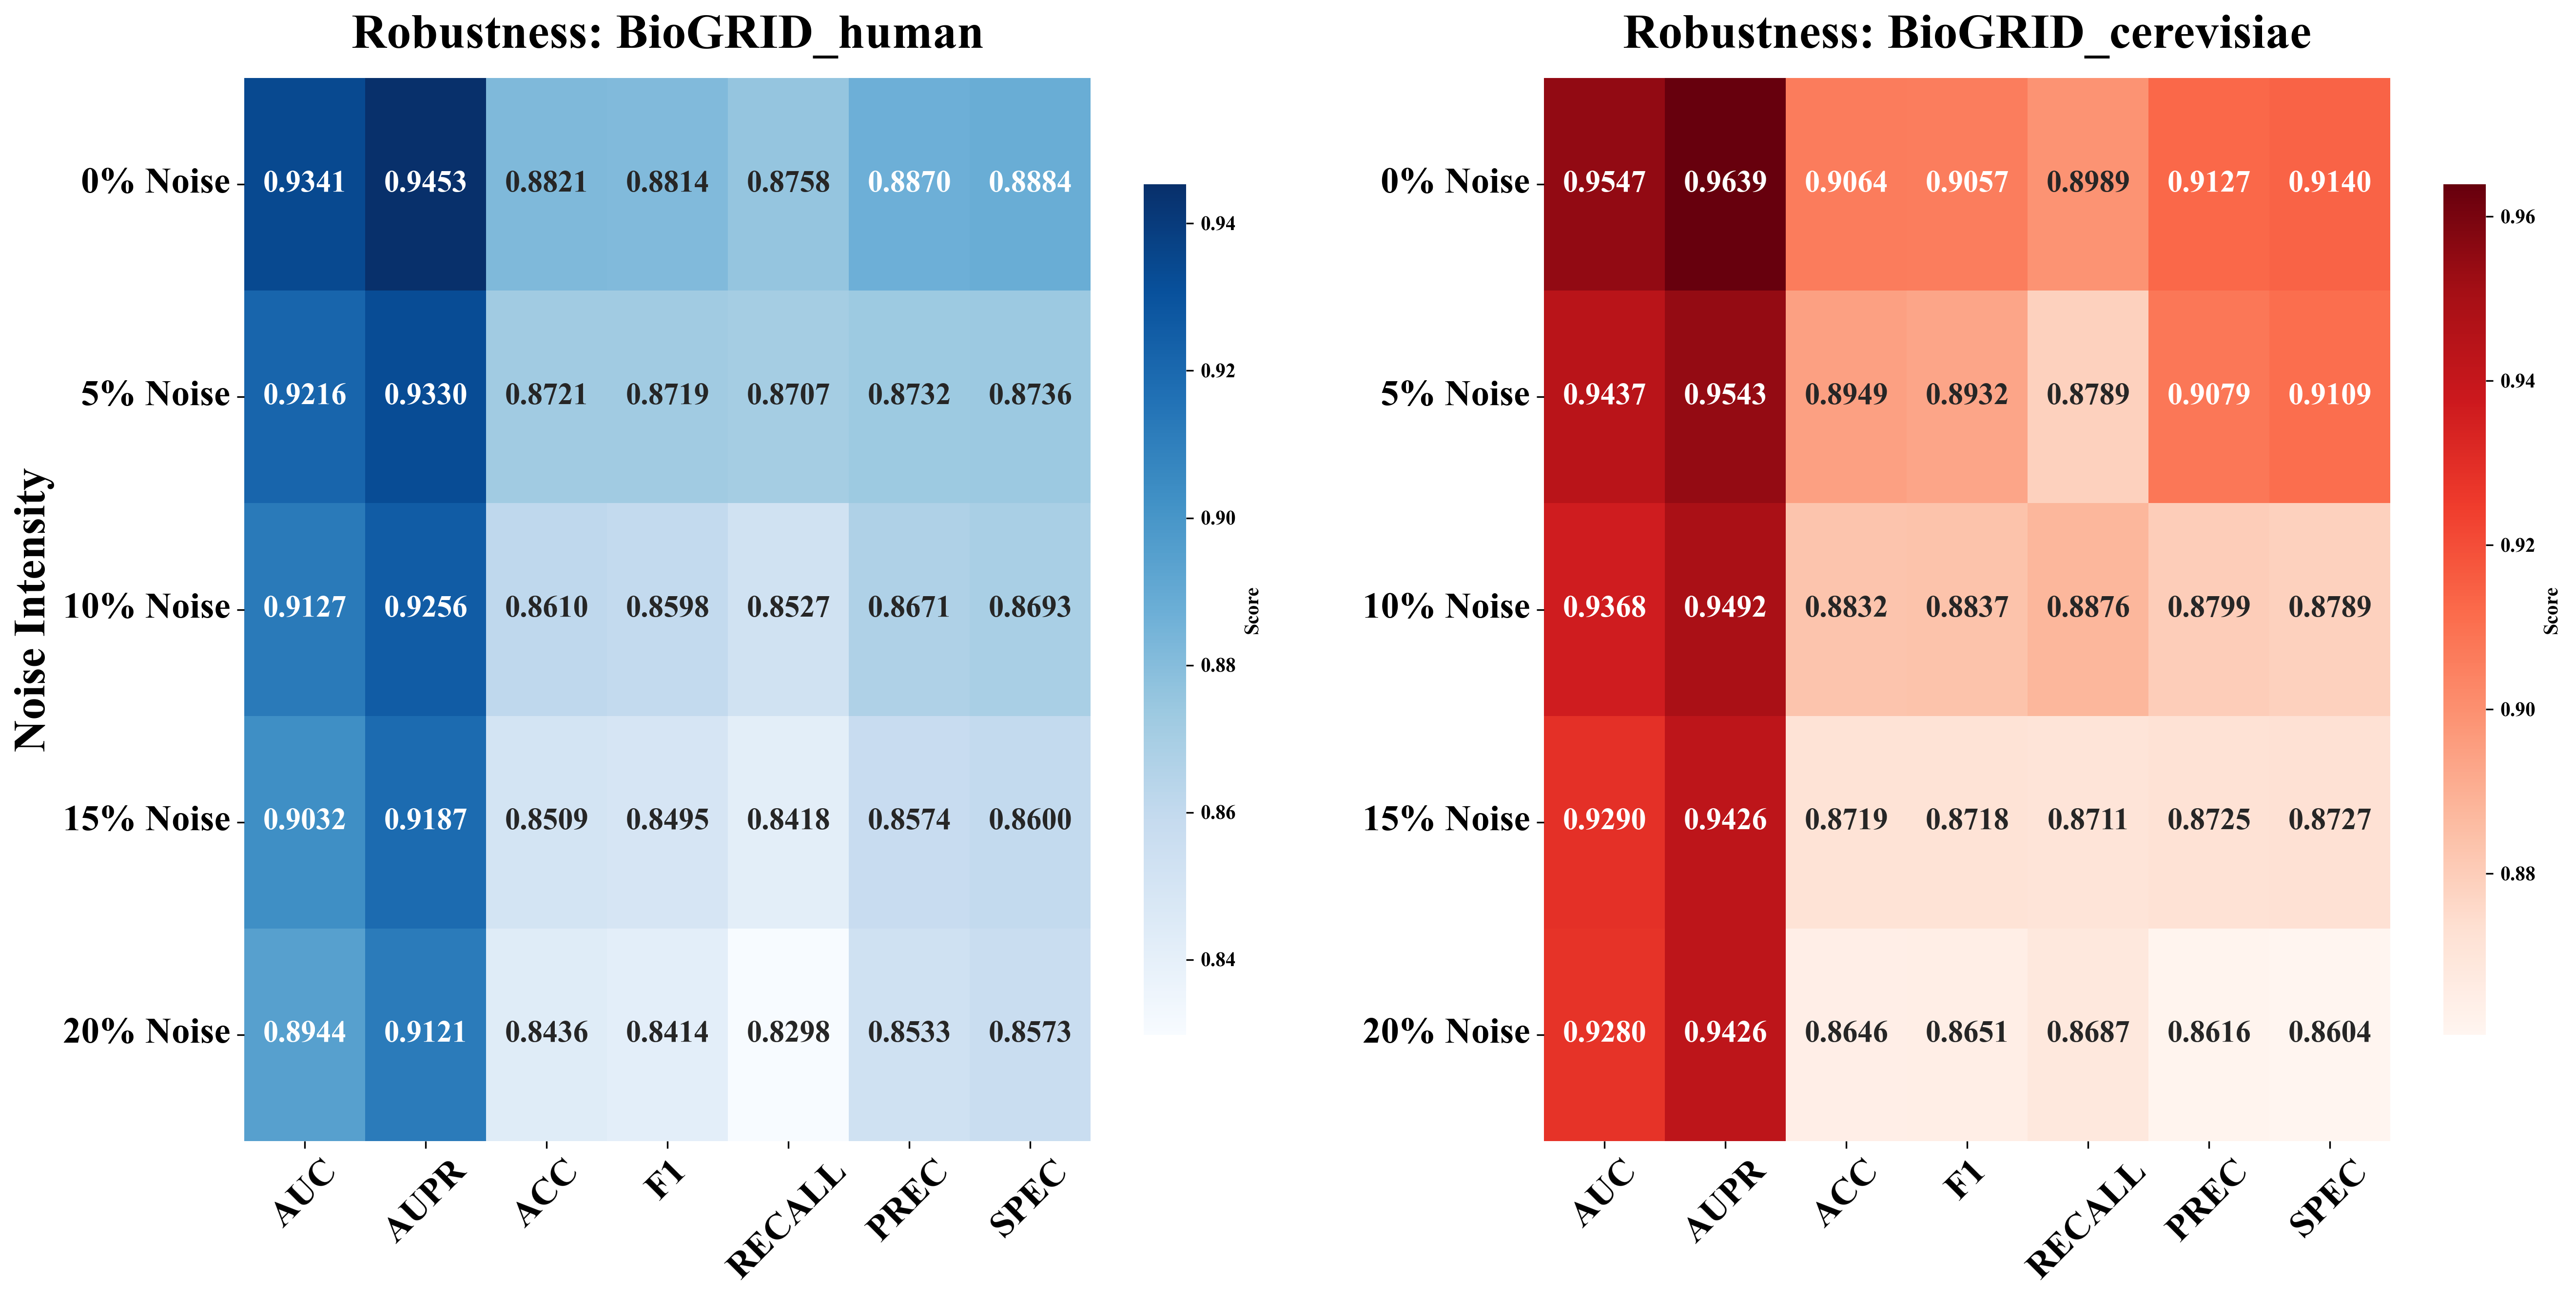
针对高通量蛋白质组学数据噪声密集的现状,本研究在训练集中随机引入 5% 与 10% 的假阳性噪声边(随机配对未确认互作的节点):
实验数据表明,GHCT 表现出令人惊讶的拓扑容错力:
- 引入 5% 噪声后,AUC 仅微降 1.08%(由 0.9534 降至 0.9437);
- 引入 10% 噪声后,AUC 仅微降 1.94%(降至 0.9368);
- 即便在 20% 的极端扰动下,模型依然能维持 0.91 以上的高判别力。这表明全局注意力与图残差能有效过滤局部随机噪声,提取本质的拓扑主干信号。
3.4 生理级不平衡数据集实验(1:5 与 1:10)
在真实活细胞内,任意两随机蛋白质相互作用的概率极低,生理数据呈现极端稀疏与不平衡特性。本研究构建了 1:5 与 1:10 的大比例负样本测试集:
令人振奋的是:模型在高度不平衡数据集上的综合表现甚至超越了 1:1 平衡数据集!
- 在 1:5 不平衡集上,AUC 达到 0.9643;
- 在 1:10 不平衡集上,AUC 达到 0.9642。
机理阐释:在平衡集训练初期,高比例的正样本容易诱导模型产生保守预测;而在引入海量负样本后,丰富的反例空间促使模型在决策流形上精准描绘出更细致的分类超曲面,极大强化了特异性(Specificity),完美契合真实生物网络的底层分布规律。
4. 局限性反思与未来展望
4.1 与大语言模型 LPBERT 的对比反思
为了客观审视当前纯拓扑 GNN 方法的边界,本研究将 GHCT 与基于预训练蛋白质语言模型的最新方法 LPBERT 进行了基准对比:
| 模型 | 数据集 | Accuracy | Precision | Recall | Specificity |
|---|---|---|---|---|---|
| GHCT (本研究) | S. cerevisiae | 90.49% | 90.39% | 90.62% | 90.78% |
| LPBERT [9] | S. cerevisiae | 97.94% | 98.60% | 97.27% | 98.61% |
| GHCT (本研究) | H. sapiens | 88.71% | 88.76% | 88.64% | 91.38% |
| LPBERT [9] | H. sapiens | 98.93% | 99.23% | 98.62% | 99.23% |
4.2 阈值漂移(Threshold Shift)现象揭秘
深入分析发现:GHCT 的 Accuracy 较其 AUC-ROC 普遍低约 5%。这一差异揭示了底层特征的一个重要现象:
- 随着模型深度拟合,最优分类判决阈值被迫推高至 $\approx 0.96$ 的极高水平,而非理想的 0.5;
- 这说明纯拓扑 GNN 在处理高度紧密连通的网络时,倾向于对所有已知连通节点打出较高的互作概率基准分。虽然模型依然能凭借排序区分正负样本(因此 AUC 极高),但较窄的分数动态间距导致固定阈值下 ACC 略有折损。
4.3 未来研究方向:多模态结构融合
纯拓扑 GNN 主要依托网络拓扑邻域推导互作,而蛋白质相互作用的物理本质最终是由三维折叠构象、表面静电势、亲疏水性分布与氨基酸基团配位决定的。 未来最富潜力的演进方向是:借助 ESM-2、AlphaFold 3 或 RoseTTAFold 提取结构-序列多模态特征,将其作为节点先验向量拼接入 GHCT 架构,融合微观物理化学先验与宏观生物网络拓扑,彻底突破单一模态的预测天花板。
5. 参考文献
- Wu Q, Liu Y B, Chen S. Attention holistic processing multi-channel graph transformer with graph residual connections for predicting lncRNA–Protein interactions. Knowledge-Based Systems, 310(15): 112957, 2025.
- Zhou H, Wang W, Jin J. Graph neural network for protein–protein interaction prediction: A comparative study. Molecules, 27(18): 6135, 2022.
- Soleymani F, Paquet E, Viktor H. Protein–protein interaction prediction with deep learning: A comprehensive review. Computational and Structural Biotechnology Journal, 20: 5316–5341, 2022.
- Zhou J, Cui G, Hu S, et al. Graph neural networks: A review of methods and applications. AI Open, 1: 57–81, 2021.
- Li H, Nithin C, Kmiecik S. Computational methods for modeling protein–protein interactions in the AI era: Current status and future directions. Drug Discovery Today, 30(6): 104382, 2025.
- Jha K, Saha S, Singh H. Prediction of protein–protein interaction using graph neural networks. Scientific Reports, 12: 8360, 2022.
- Xu M, Qian P, Zhao Z. Graph neural networks for protein-protein interactions: A short survey. arXiv:2404.10450, 2024.
- Lv G, Hu Z, Bi Y. Learning unknown from correlations: Graph neural network for Inter-novel-protein interaction prediction. arXiv:2105.06709, 2021.
- Hu A, Kuang L, Yang D. LPBERT: A Protein–Protein Interaction Prediction Method Based on a Pre-Trained Language Model. Applied Sciences, 15(6): 3283, 2025.
致 谢
本课题的研究与毕业论文的撰写,凝聚了许多人的关怀与支持。
首先,由衷感谢我的指导教师李宏老师。李老师在计算生物学与分子建模领域的深厚造诣、严谨求实的治学态度,以及在课题选题、实验设计与数据分析过程中的悉心点拨,使我受益匪浅。
感谢海南大学生命健康学院提供的科研计算平台与学术环境,感谢实验室同窗在模型训练与调试期间给予的宝贵建议与技术探讨。
四载求学,感谢家人无条件的信任、包容与守候,赋予我不断探索前沿未知的勇气与笃定。